Quando alguém fala em “cloud caiu”, a reação mais comum é imaginar um plano gigante, caro e cheio de arquitetura de banco. Só que o post técnico do Monzo sobre o Stand-in mostra uma lição mais útil para quem não tem orçamento infinito: resiliência boa começa decidindo o que precisa continuar vivo quando quase todo o resto falha.
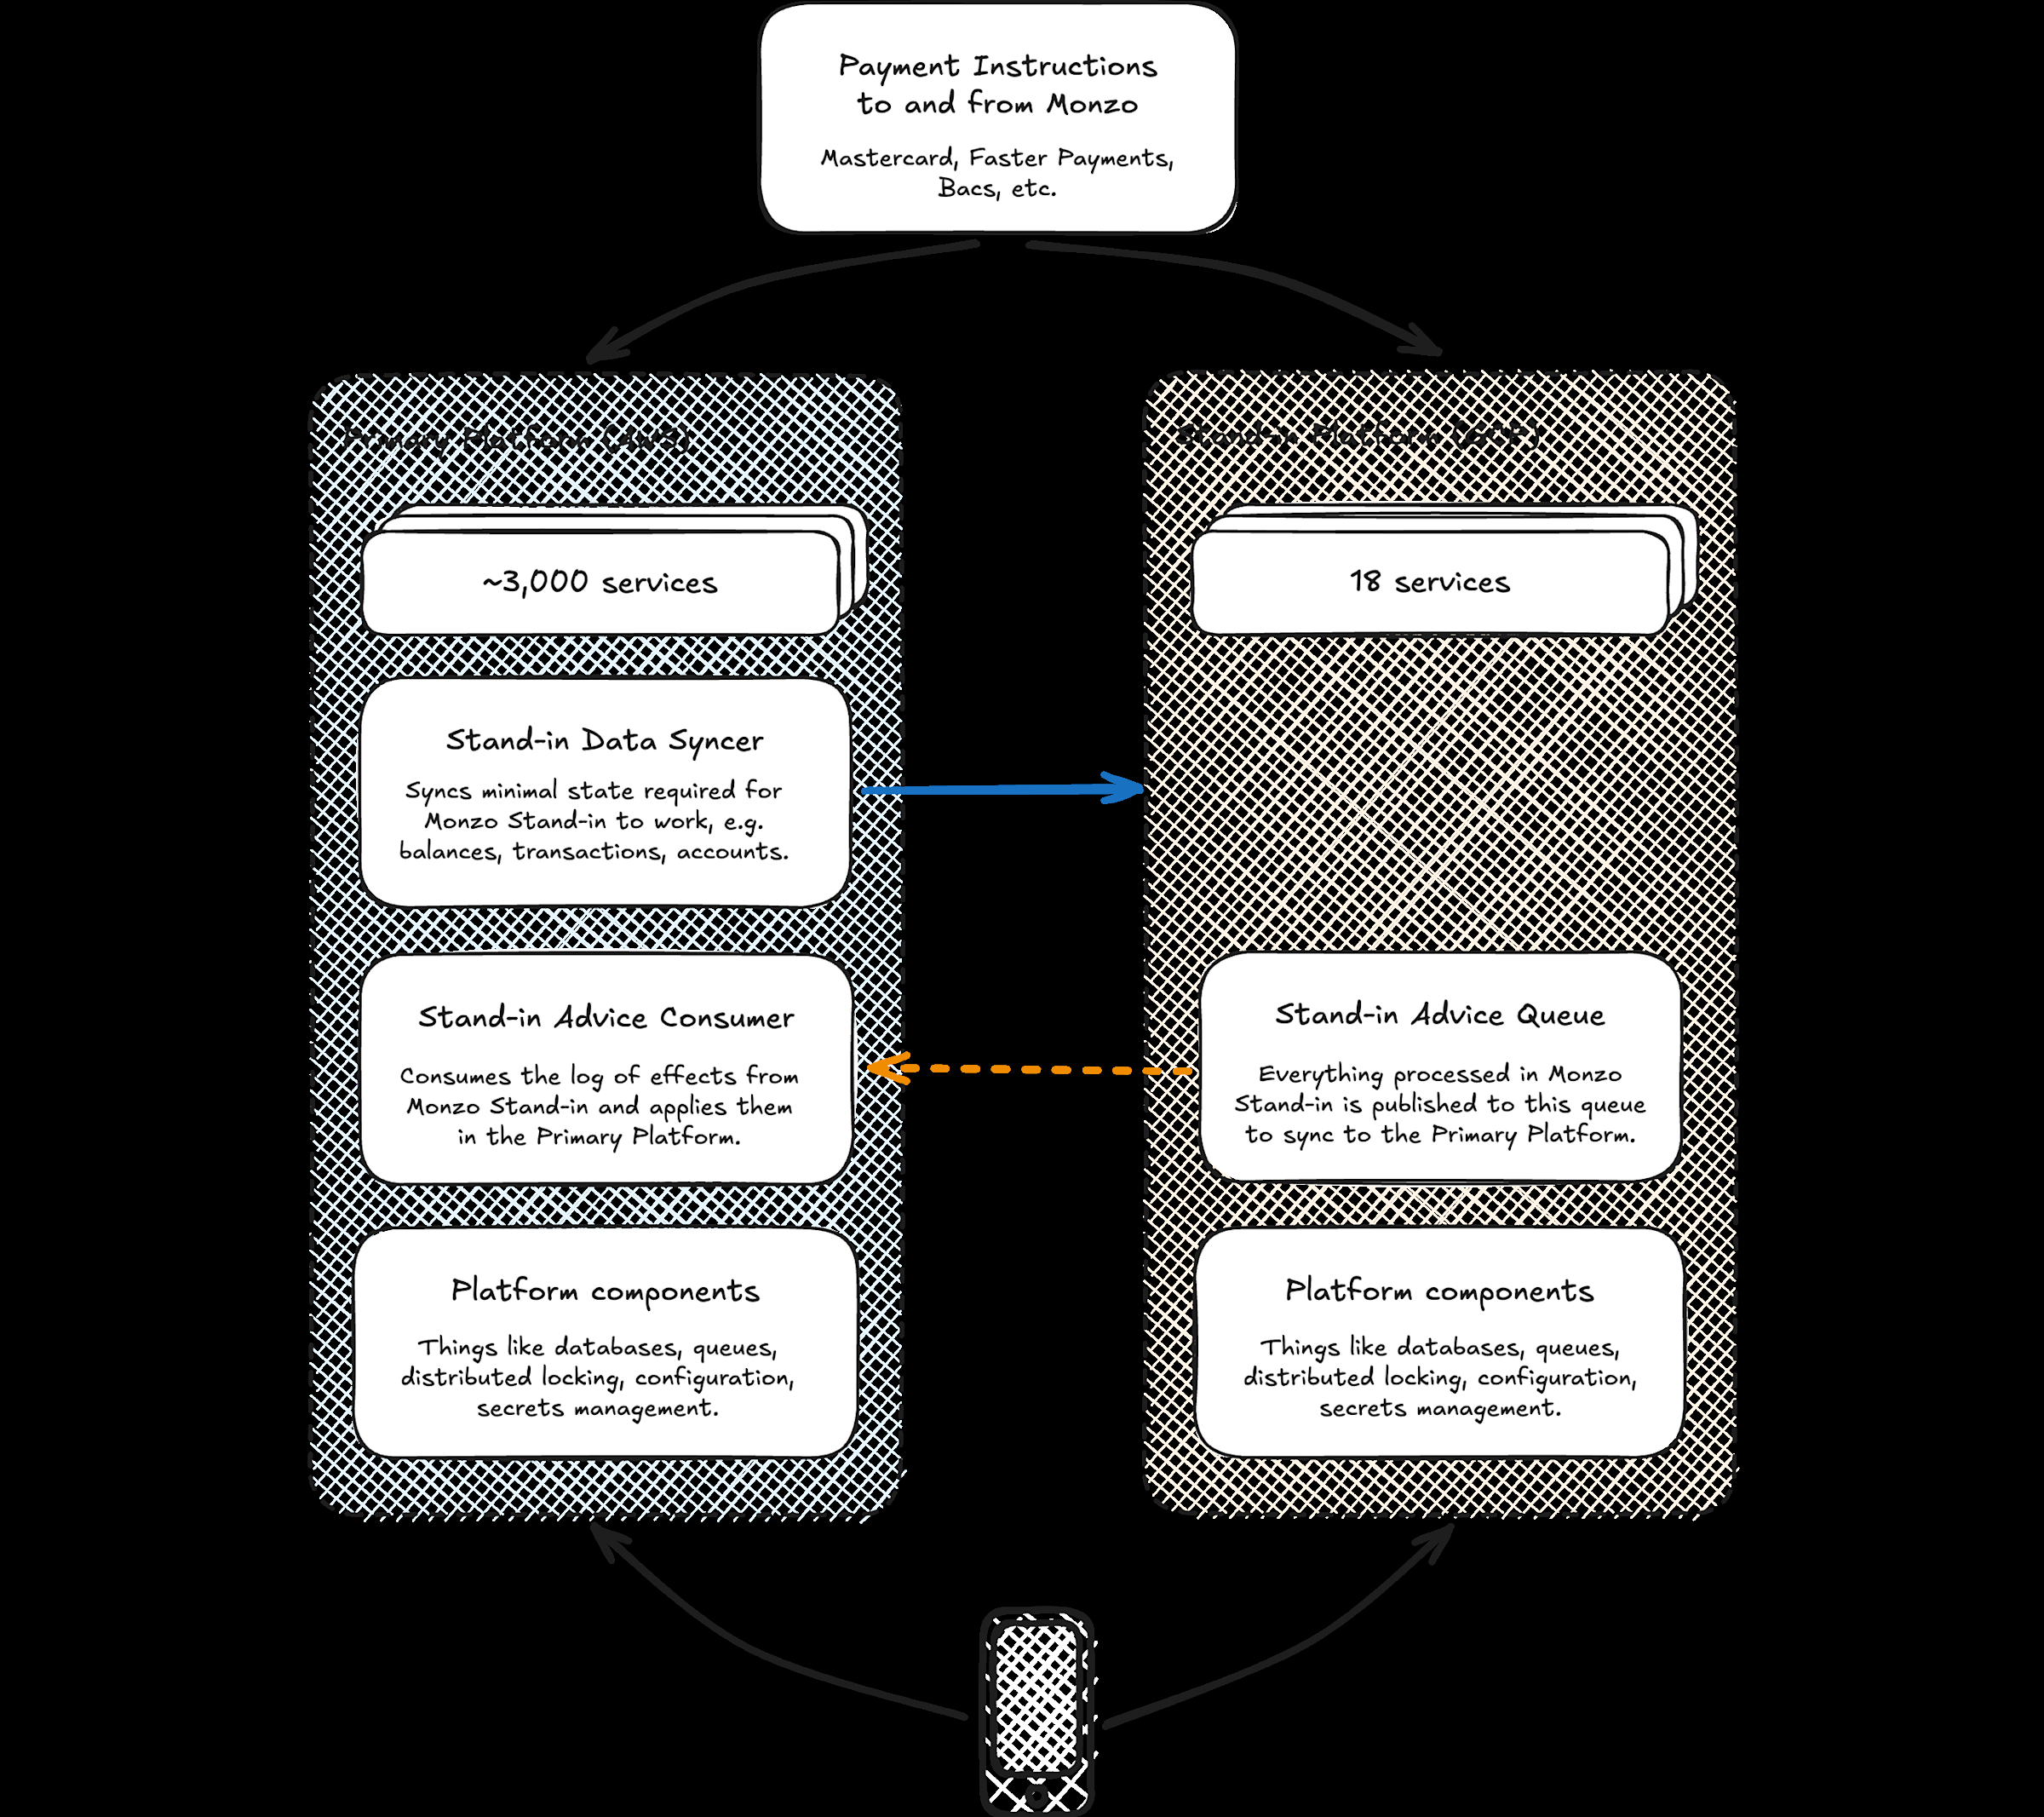
O caso é forte porque não é teoria de slide. O banco digital descreveu uma infraestrutura de contingência separada, rodando no Google Cloud, capaz de assumir funções críticas quando a plataforma principal na AWS passa por um incidente grande. Não é uma cópia completa do sistema. É um modo reduzido, desenhado para manter o essencial.
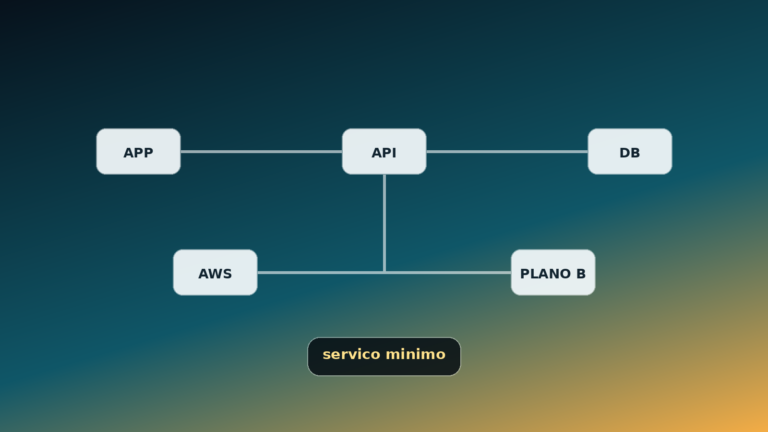
Para um time pequeno, a pergunta não é “como copiar o Monzo?”. A pergunta honesta é: se nossa stack principal ficar indisponível hoje, qual pedaço do produto ainda precisa respirar?
O plano B não precisa ser outro produto inteiro
Um erro comum em conversa de disaster recovery é tentar imaginar uma réplica perfeita de tudo. Mesma aplicação, mesmo banco, mesma fila, mesmo comportamento, só que em outro provedor. Parece bonito no quadro. Na vida real, costuma virar caro, frágil e difícil de testar.
O Monzo tomou outro caminho: uma plataforma independente, com serviços próprios, menor e limitada ao que os clientes precisam numa crise. No texto, eles citam recursos como compras no cartão, saques, transferências, saldo, transações e congelar ou descongelar cartão.
Esse recorte é a parte que dá para trazer para times menores. Talvez seu produto não precise aceitar todas as ações durante um apagão. Talvez precise só mostrar status, preservar pedidos, manter login de emergência, congelar operações sensíveis, aceitar fila assíncrona ou impedir perda de dados.
Sistema diferente reduz falha repetida
Outra sacada importante do caso: o Stand-in não roda os mesmos microserviços da plataforma principal. Isso parece estranho à primeira vista, mas faz sentido. Se a falha vier de um bug, de uma migração ruim ou de uma dependência compartilhada, copiar a mesma arquitetura pode copiar também o mesmo problema.
Para uma operação menor, isso não significa criar outro time de plataforma. Significa evitar que o plano de emergência dependa exatamente das peças que costumam quebrar. Uma página de status estática não deve depender do mesmo cluster principal. Um modo de leitura crítica não deveria exigir a mesma fila congestionada. Um botão de pausa operacional não pode morar só dentro do painel que fica fora do ar no incidente.
O modo degradado precisa aparecer para o usuário
O Monzo também mudou a interface do app quando o Stand-in está ativo. Em vez de fingir normalidade, o aplicativo mostra uma experiência simplificada, com o conjunto de funções que ainda está disponível.
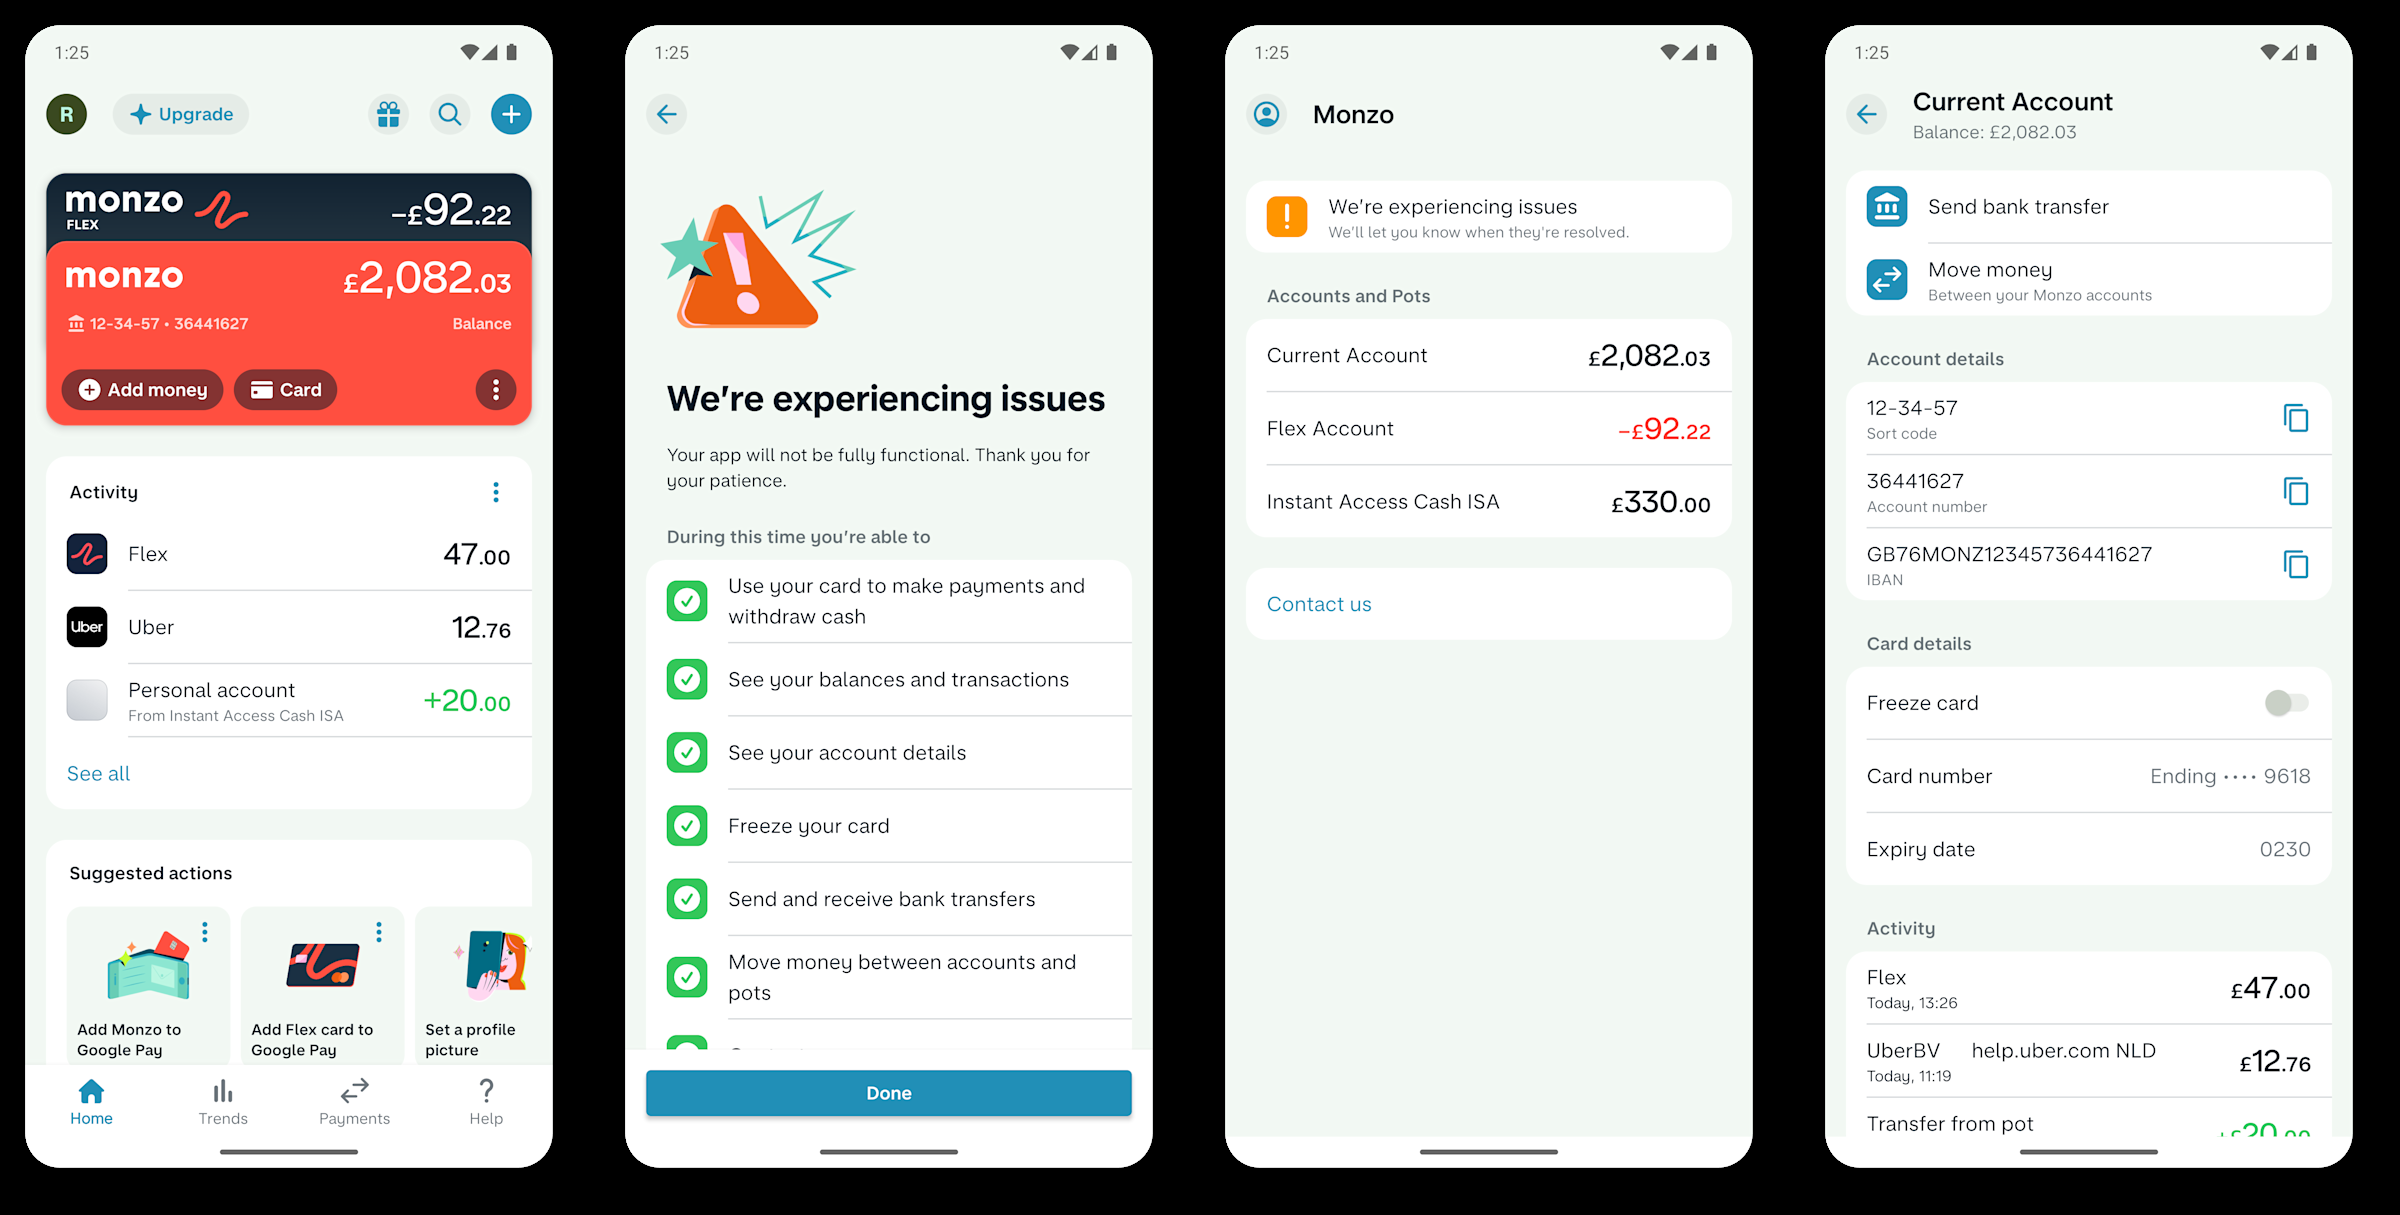
Isso é mais raro do que deveria. Muito produto tenta esconder instabilidade até o usuário bater numa parede. O resultado é pior: suporte lotado, usuário tentando a mesma ação dez vezes e time de engenharia tentando entender se o problema é técnico ou só falta de comunicação.
Modo degradado bom não é vergonha. É contrato claro. “Isto funciona. Isto está temporariamente limitado. Isto entra em fila. Isto você não deve tentar agora.” Em incidentes, clareza também é feature.
O relatório do GitHub reforça a mesma ideia
O relatório de disponibilidade do GitHub de agosto de 2026 vai pelo mesmo caminho por outro ângulo. A empresa registrou cinco incidentes com degradação de serviços no mês e listou reparos em monitoramento de capacidade, políticas de retry, resiliência de serviços principais, isolamento e proteção contra sobrecarga.
O detalhe interessante é que o GitHub não vendeu a narrativa de “nunca mais vai cair”. A frase que resume o relatório é bem mais realista: disponibilidade, depois capacidade, depois funcionalidades.
Para quem trabalha em time pequeno, essa ordem é um bom antídoto contra ansiedade de roadmap. Não adianta lançar mais coisa se o básico não aguenta pico, retry ruim amplia incidente, alerta não separa ruído de impacto e todo caminho crítico depende da mesma peça cansada.
O que dá para copiar sem virar Monzo
Não precisa transformar um SaaS de 12 pessoas em laboratório de arquitetura bancária. Mas dá para copiar o raciocínio:
- liste as três ações que não podem morrer durante um incidente;
- defina o que pode virar modo somente leitura sem destruir a experiência;
- tenha uma página de status e comunicação que não dependam do stack principal;
- teste manualmente o caminho de emergência antes de precisar dele;
- trate retry, fila e timeout como design de produto, não detalhe escondido;
- separe alerta que incomoda de alerta que realmente muda prioridade.
A Engenharia de Plataforma entra justamente nesse ponto. O texto da GeekHunter sobre o tema fala de reduzir carga cognitiva dos devs com plataformas internas, templates, automações e padrões. Em resiliência, isso vira algo bem concreto: deixar o caminho seguro mais fácil do que o improviso.
O mínimo vivo é uma decisão de produto
A parte mais madura do caso do Monzo não é “usar duas clouds”. É admitir que nem tudo merece continuar funcionando do mesmo jeito numa crise.
Quando tudo é crítico, nada é crítico. Quando todo serviço precisa ser replicado, o plano de emergência vira outro sistema complexo para quebrar. O caminho mais prático é escolher o mínimo vivo: as ações que protegem usuário, dinheiro, dados, operação e confiança.
Para times pequenos, isso já é um avanço enorme. Não resolve todo incidente. Mas troca o pânico de “a cloud caiu” por uma pergunta melhor: o que ainda precisa funcionar, com menos dependência, menos promessa e mais clareza?