Tem uma economia falsa rondando o uso de agentes de IA no desenvolvimento: olhar para a conta de tokens como se ela fosse a conta inteira.
Parece intuitivo. Se a resposta do terminal ficou menor, se o prompt ficou mais curto, se cada chamada usa menos contexto, então o fluxo deve estar mais barato. Só que, na prática, agente não trabalha em chamada isolada. Ele trabalha em sequência: lê, interpreta, chama ferramenta, erra, corrige, recupera contexto, roda teste, chama outro agente, volta para o diff.
É aí que a conta muda. Um agente “barato” no pedaço errado do fluxo pode sair caro no resultado final.
A métrica local que engana
O GitHub publicou uma análise bem útil sobre como reduziu custo no Copilot sem piorar a qualidade da tarefa. O ponto mais interessante não é uma otimização específica. É a tese: não otimize a chamada da ferramenta; otimize a tarefa concluída.
No teste citado pelo GitHub, encurtar demais a saída de comandos parecia uma vitória local. A ferramenta devolvia menos texto para o agente. Só que, quando o detalhe removido fazia falta, o modelo precisava reabrir a saída original, repetir comando ou carregar mais contexto depois. Resultado: a resposta individual ficou mais curta, mas o fluxo completo gastou mais tempo e mais tokens.
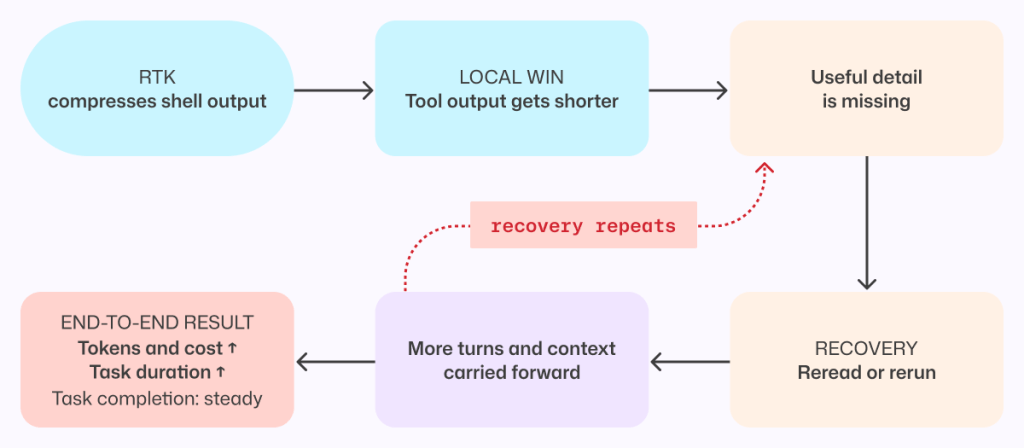
Para quem usa agente no dia a dia, isso explica aquela sensação estranha de “a IA foi rápida, mas o trabalho ficou arrastado”. O problema não está só no modelo. Está no atrito entre contexto, ferramenta, instrução e validação.
Contexto demais é desperdício. Contexto de menos é retrabalho
A parte difícil não é simplesmente “dar menos contexto”. É dar contexto suficiente para o agente não se perder.
O GitHub separou melhor os tipos de saída. Conteúdo parecido com código, como cat, git diff e scripts arbitrários, foi preservado. Resultado de busca pôde ser reorganizado sem perder informação. Já logs repetitivos de install, build, teste e progresso foram comprimidos quando fazia sentido.
Essa diferença importa. Um log de instalação com 400 linhas repetidas raramente precisa ir inteiro para o modelo. Um diff, por outro lado, pode ter uma linha aparentemente pequena que muda completamente a edição.
A regra prática para times dev é simples: antes de comprimir, pergunte o que aquela saída representa. Se é ruído previsível, dá para resumir. Se é evidência técnica, código, erro específico ou decisão de arquitetura, cortar pode virar dívida alguns minutos depois.
Prompt curto também pode quebrar comportamento
Outra parte boa do relato do GitHub é quase um aviso para quem adora “prompt minimalista”. O time reduziu instruções acumuladas em ferramentas de agentes, mas uma primeira versão criou regressão: agentes que poderiam rodar em paralelo passaram a se comportar de forma mais serializada.
O problema não era o prompt menor. Era o comportamento perdido no corte.
Isso vale para uso individual e para empresa. Se você tem um prompt de agente que diz como abrir PR, quando rodar teste, quando chamar revisão, como tratar comandos destrutivos e como lidar com tarefas paralelas, ele não pode ser enxugado só no olho. Precisa de teste de comportamento.
Um prompt mais curto que apaga uma regra operacional importante não economiza. Ele só transfere o custo para bug, retrabalho ou revisão humana.
O agente virou uma persona da plataforma
No Stack Overflow, Andi Gutmans, do Google, trouxe outro ângulo que conversa muito com isso: em escala, o agente passa a ser uma persona que a plataforma precisa atender. Não é só o dev humano usando ferramenta. É o dev, os agentes em nome dele, a camada de dados, a busca, a governança, os limites e a observabilidade.
Quando uma pessoa clica em botões, existe um teto natural. Quando dezenas de agentes trabalham em paralelo, esse teto desaparece. Eles não dormem, repetem chamadas, consultam ferramentas, carregam dados e podem rodar 24 horas se ninguém colocar limite.
Por isso custo de agente não é só preço do modelo. É também arquitetura de contexto, política de ferramenta, logging, recuperação, segurança, avaliação e governança.
O que isso muda para quem vive de TI
Se você é dev usando agentes sozinho, a lição é não medir produtividade pela sensação de velocidade. Meça pelo pacote inteiro:
- o agente terminou a tarefa sem você refazer metade?
- ele preservou contexto importante?
- ele repetiu comandos por falta de informação?
- o diff ficou revisável?
- o teste que validaria a mudança rodou mesmo?
Se você lidera time ou mexe com plataforma, a pergunta sobe de nível. Não basta liberar uma ferramenta de IA e torcer para a conta fechar. Precisa decidir o que pode rodar, qual contexto entra, quais comandos exigem confirmação, que logs serão comprimidos, quando recuperar saída completa e quais métricas realmente indicam tarefa concluída.
O ponto não é frear a IA. É parar de tratar agente como autocomplete com esteroide. Quando ele começa a chamar ferramenta, rodar tarefa em segundo plano e operar como parte do fluxo de engenharia, ele vira infraestrutura.
A conta certa
A pergunta menos útil é “quantos tokens essa chamada economizou?”.
A pergunta melhor é: essa mudança reduziu o custo da tarefa pronta sem piorar qualidade, revisão e confiança?
Essa diferença parece pequena, mas muda tudo. Porque um agente eficiente não é o que fala menos. É o que chega ao resultado com menos volta inútil, menos contexto desperdiçado e menos trabalho escondido para o humano consertar depois.
No fim, o agente caro nem sempre é o que usa mais tokens. Muitas vezes é o que parece econômico até você descobrir que ele só empurrou a conta para o próximo passo.