Às vezes o incidente não começa no banco, no deploy ou naquele microserviço que todo mundo já olha torto.
No caso da Telstra, a maior operadora móvel da Austrália, a história começou com algo bem menos vistoso: tempo. Um receptor GPS em um chassi de Melbourne voltou de manutenção acreditando que o ano era 2006. A rede aceitou essa referência, e o erro se espalhou.
Segundo a análise publicada pela Netnod, em 8 de julho de 2026 parte da rede móvel da Telstra parou de funcionar. Chamadas de voz não completavam, SMS não chegavam e até chamadas para o número de emergência australiano foram afetadas. O impacto respingou em trens, terminais de pagamento, bilhetagem e carregadores de veículos elétricos.
Não foi ataque. Não foi fibra rompida. Não foi falta de energia. Foi arquitetura de tempo degradada ao longo de anos, até o dia em que ela precisou se defender de uma fonte errada e já não tinha independência suficiente para discordar.
Por que tempo derruba sistema?
Para quem trabalha com aplicação web, “horário errado” costuma lembrar log bagunçado, token expirando antes da hora ou bug chato de timezone. Em rede móvel, a conversa é mais séria.
Redes modernas dependem de sincronização precisa. Em tecnologias que alternam transmissão e recepção em intervalos muito curtos, como TDD, as células precisam concordar sobre quando cada uma deve falar e quando deve escutar. Se uma parte sai do passo, a rede começa a interferir nela mesma.
Esse é o ponto que torna o caso tão bom para quem trabalha com infra, cloud, SRE ou operação: tempo não é detalhe de relógio no canto da tela. Tempo é dependência de produção.
O bug famoso: o GPS achou que era 2006
GPS transmite tempo usando um contador de semanas. Em sinais civis clássicos, esse contador tem 10 bits, então ele volta ao começo a cada 1.024 semanas, algo perto de 19,6 anos. O receptor precisa saber em qual “época” está para transformar aquele número no ano certo.
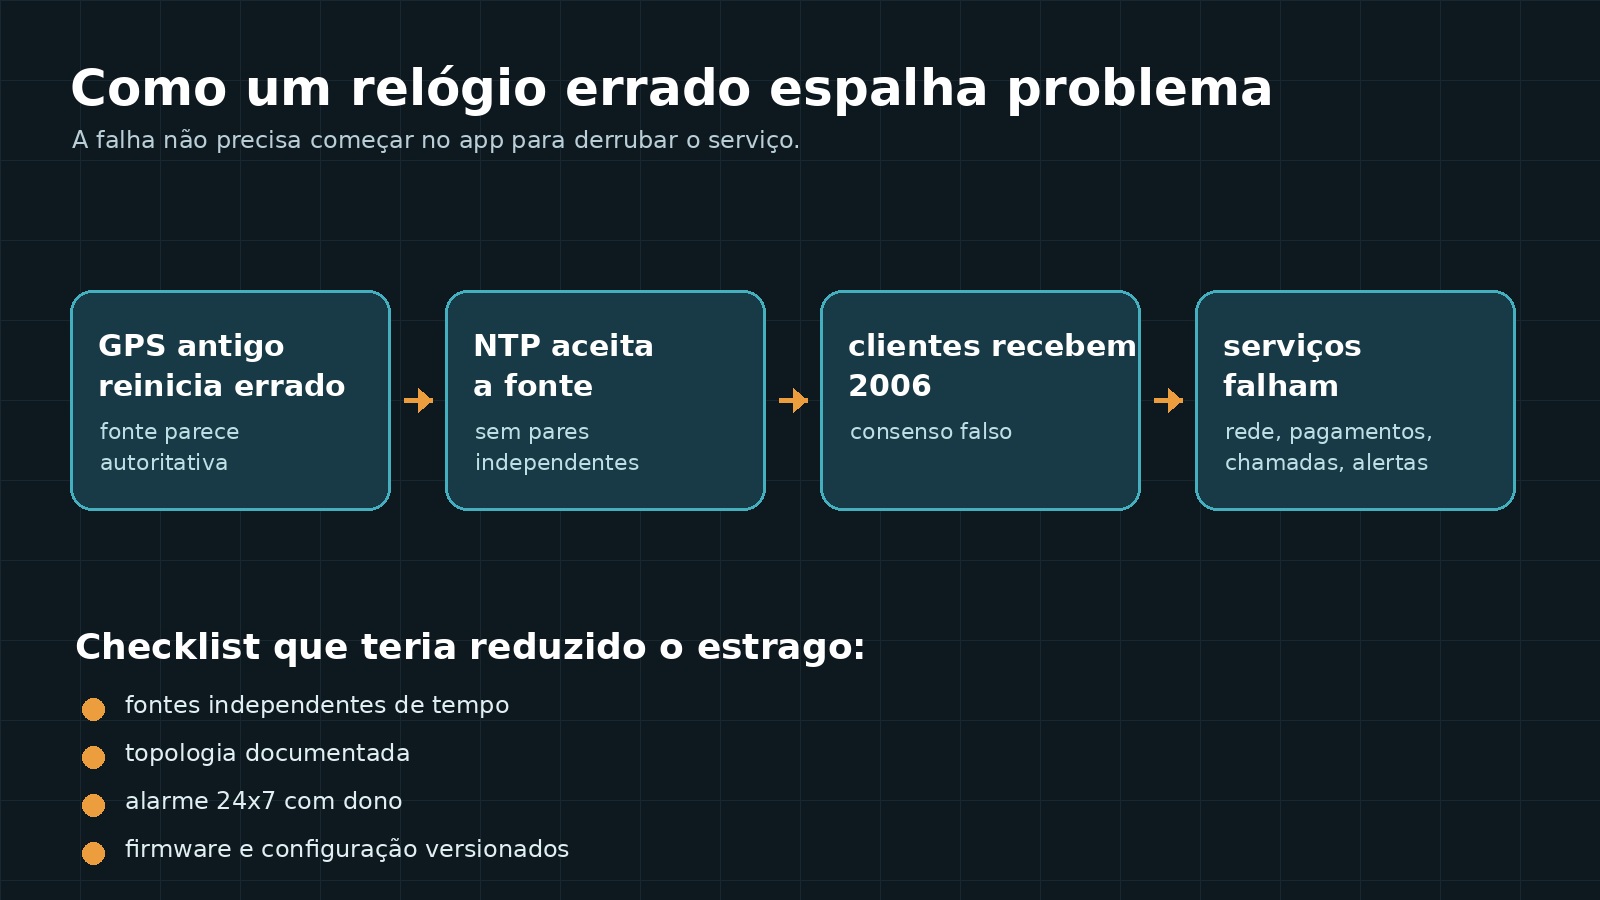
No caso descrito pela Netnod, o cartão GPS antigo em Melbourne tinha passado pelo rollover de 2019 sem problema enquanto seguia ligado. Mas, ao ser desligado e ligado de novo após manutenção, precisou recalcular a época a partir do firmware. Como o firmware não estava atualizado, voltou 1.024 semanas no tempo.
Até aí, o estrago ainda poderia ter sido contido. Uma fonte de tempo errada, em uma arquitetura bem desenhada, deveria ser confrontada por outras fontes independentes. O problema é que a topologia já não era mais a mesma do desenho original.
A parte perigosa: o protocolo funcionou, a arquitetura não
O detalhe mais interessante do caso é que o NTP não “bugou” no sentido simples. Ele fez o que foi configurado para fazer. O problema é que as defesas que o NTP usa dependem de fontes realmente independentes.
A análise da Netnod descreve duas proteções importantes. A primeira é preferir fontes mais próximas da referência, usando a hierarquia de estratos. A segunda é comparar várias fontes e descartar aquela que discorda muito das outras.
Mas, ao longo dos anos, a arquitetura mudou. Um upgrade de 2020 reduziu redundância. Depois, uma correção feita para resolver perda de contato com uma fonte em Sydney ativou um GPS local em Melbourne. Na prática, esse servidor acabou promovido para uma posição extremamente autoritativa na hierarquia.
Quando o GPS acordou achando que era 2006, ele não parecia apenas mais uma fonte qualquer. Ele parecia uma fonte forte. E, pior: as fontes que poderiam contradizê-lo estavam abaixo dele ou já haviam perdido independência real.
É o tipo de falha que assusta porque passa anos parecendo estável. A rede opera, os alertas param, a gambiarra vira normalidade, e ninguém percebe que a arquitetura deixou de ter uma saída de emergência.
O paralelo com automação e agentes de IA
Esse caso também conversa com uma pauta bem atual: agentes de IA em infraestrutura e resposta a incidentes.
Ferramentas como AURA, da Mezmo, e experimentos multiagente de investigação SRE mostram uma direção clara: a automação está ficando mais perto do plantão. Ela consegue correlacionar logs, métricas, deploys e até propor correções. Isso é útil. Em alguns cenários, pode economizar horas.
Mas o caso da Telstra é um lembrete de que produção não perdoa autoridade mal colocada. Se uma fonte parece confiável, mas ninguém validou sua independência, o sistema inteiro pode automatizar a direção errada com muita convicção.
Na prática, o recado para times que estão colocando IA em operação é simples: o agente pode investigar, resumir, sugerir e abrir PR. Mas as fronteiras precisam estar claras. Quem pode executar? Quem pode mudar infra? Quais fontes de verdade ele consulta? O que acontece quando as evidências concordam entre si porque vieram do mesmo lugar?
As lições que servem para qualquer time de TI
Mesmo que você nunca encoste em uma rede móvel, a história dá uma checklist muito boa.
1. Trate tempo como dependência crítica
NTP, firmware de GPS, hierarquia de fontes, timezone de servidor e sincronização entre regiões não são “detalhes de plataforma”. Se o seu sistema depende de sessão, token, fila, assinatura, pagamento, auditoria ou ordem de eventos, tempo faz parte da confiabilidade.
2. Redundância precisa ser independente de verdade
Ter três fontes que repetem a mesma mentira não é redundância. É eco. A pergunta boa não é só “tem fallback?”. É “esse fallback consegue discordar da fonte principal quando ela estiver errada?”.
3. Mudança pequena também muda arquitetura
No caso Telstra, decisões feitas em anos diferentes pareciam defensáveis isoladamente. Uma troca de hardware aqui, um peering ali, um GPS ativado para resolver um sintoma. Somadas, essas decisões mudaram a arquitetura real.
Esse é um padrão conhecido em produção: a documentação descreve o sistema que existia; o ambiente roda o sistema que foi remendado.
4. Alarme sem dono é quase documentação
A Netnod destaca que alarmes da plataforma de tempo não estavam integrados do jeito certo ao monitoramento padrão e tinham tratamento limitado. Isso é familiar demais em TI: o alerta existe, mas não chega a quem decide; chega sem severidade; chega sem runbook; ou chega em horário comercial para algo que quebra de madrugada.
5. Golden config vale ouro
Configuração boa conhecida, versionada e checada automaticamente teria aumentado muito a chance de perceber drift, firmware antigo e topologia suspeita antes do incidente.
Essa lição vale para NTP, Kubernetes, firewall, banco, IAM, pipeline e qualquer coisa que pareça “estável demais para mexer”.
O ponto que fica
O caso é quase poético para quem gosta de infraestrutura: uma rede enorme caiu porque perdeu a noção compartilhada de “agora”. Mas a leitura prática é menos bonita e mais útil.
Produção quebra quando dependências invisíveis deixam de ser tratadas como dependências. Tempo é uma delas. Confiança entre fontes é outra. Revisão de arquitetura depois de mudanças pequenas também.
Se o seu sistema só está de pé porque todo mundo concorda com a mesma fonte, vale perguntar uma coisa antes do próximo plantão: essa fonte está certa ou só ficou impossível discordar dela?